Imaginez que vous lancez un dé à six faces et que vous notez le résultat obtenu. Ce résultat est imprévisible avant le lancer, mais il ne peut prendre que six valeurs bien distinctes : 1, 2, 3, 4, 5 ou 6. C'est précisément ce que capte la notion de variable aléatoire discrète : une quantité numérique dont la valeur dépend du hasard, et dont l'ensemble des valeurs possibles est fini ou, au plus, infini mais énumérable un à un. Comprendre cette notion, c'est poser la première pierre de toute la théorie des probabilités ; un outil indispensable aussi bien en statistiques, en physique, en informatique qu'en économie.
Ce cours guide pas à pas, depuis la définition rigoureuse jusqu'au calcul de l'espérance et de la variance, en passant par des exemples concrets issus du quotidien. Chaque notation est expliquée dès sa première apparition, et chaque formule est justifiée intuitivement avant d'être démontrée.
Définition d’une variable aléatoire discrète
Avant d'entrer dans le vif du sujet, rappelons le cadre général. En probabilités, on modélise toujours une expérience aléatoire par un espace probabilisé ; c'est-à-dire un triplet où :
- (lire « oméga ») désigne l'univers, l'ensemble de toutes les issues possibles de l'expérience ;
- est une tribu (ou sigma-algèbre), la famille des événements auxquels on peut attribuer une probabilité ;
- est la mesure de probabilité, une fonction qui à chaque événement associe un nombre entre 0 et 1.
Une variable aléatoire est alors simplement une façon de « coder » numériquement les issues de l'expérience. Plus précisément :
Définition : Variable aléatoire discrète
Soit un espace probabilisé. Une variable aléatoire réelle est une application
telle que, pour tout réel , l'ensemble soit un événement (c'est-à-dire appartienne à ).
On dit que est discrète lorsque son ensemble image est fini ou dénombrable (c'est-à-dire que ses valeurs peuvent être énumérées une par une, même s'il en existe une infinité).
En pratique, cela signifie que ne peut prendre qu'une liste (éventuellement longue, mais listable) de valeurs : Il peut s'agir d'entiers, de rationnels, ou de n'importe quels réels ; l'essentiel est qu'on puisse les compter.
⚠️ Erreur fréquente : On confond souvent « discrète » et « finie ». Une variable aléatoire discrète peut très bien prendre une infinité de valeurs (par exemple ), à condition que cet ensemble soit dénombrable. L'opposé de « discrète » est « continue » (les valeurs remplissent un intervalle réel), pas « infinie ».
Exemples fondamentaux
- Lancer d'un dé à six faces : est le résultat obtenu. ; variable discrète finie.
- Rang du premier « pile » lors de lancers successifs : ce rang peut valoir 1, 2, 3, … sans limite. ; variable discrète infinie.
- Indicatrice d'un événement : si , et sinon. C'est la variable discrète la plus simple ; elle ne prend que deux valeurs.
La loi de probabilité d’une variable aléatoire discrète
Une fois la variable bien définie, la question centrale est : avec quelle probabilité prend-elle chacune de ses valeurs ? C'est précisément ce que décrit la loi de probabilité.
Définition : Loi de probabilité (distribution)
Soit une variable aléatoire discrète à valeurs dans . La loi de probabilité de est la donnée de toutes les probabilités
Ces probabilités vérifient nécessairement : pour tout , et
On représente souvent la loi de dans un tableau de distribution :
| 1 | 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|---|
La somme des probabilités vaut bien . ✓
Fonction de répartition
Un outil complémentaire est la fonction de répartition , définie pour tout réel par :
Elle est croissante, en escalier (puisque est discrète), et tend vers 0 à et vers 1 à . Chaque « saut » de hauteur survient à l'abscisse . On calcule facilement : .
Pour aller plus loin sur la construction des espaces probabilisés, consultez notre cours sur les probabilités conditionnelles et la formule de Bayes.
L’espérance mathématique : la « valeur moyenne » d’une variable aléatoire discrète
Connaître la loi de est une information complète mais parfois dense. Pour résumer le comportement de en un seul nombre, on calcule son espérance mathématique ; l'analogue probabiliste de la moyenne.
Définition et théorème : Espérance d’une variable aléatoire discrète
Soit une variable aléatoire discrète à valeurs dans avec . On dit que admet une espérance si la série converge. Dans ce cas, l'espérance mathématique de est :
Intuitivement, représente la valeur que l'on « espère » obtenir en moyenne si on répétait l'expérience un très grand nombre de fois.
Exemple : Tombola
Un jeu de tombola propose : gagner 100 € avec probabilité , gagner 10 € avec probabilité , rien sinon. Soit le gain en euros :
| 0 | 10 | 100 | |
|---|---|---|---|
L'espérance est :
Si le billet coûte 3 €, le jeu est dit équitable ; en moyenne, on ne gagne ni ne perd.
Propriétés de l’espérance
Soient et deux variables aléatoires discrètes d'espérances finies, et . Alors :
- Linéarité : .
- Positivité : si , alors .
- Variable certaine : si (constante), alors .
- Théorème de transfert : pour toute fonction ,dès que cette série converge absolument.
⚠️ Erreur fréquente : Le théorème de transfert signifie que en général. Par exemple, . Cette inégalité est au cœur de la définition de la variance.
Variance et écart type : mesurer la dispersion
L'espérance donne la valeur centrale, mais deux variables peuvent avoir la même espérance tout en se comportant très différemment : l'une concentrée autour de sa moyenne, l'autre très éparpillée. C'est le rôle de la variance de quantifier cet écartement.
Définition : Variance et écart type
Soit une variable aléatoire discrète admettant une espérance . On dit que admet une variance si est intégrable. Dans ce cas, la variance de est :
L'écart type de est . Il est exprimé dans la même unité que , ce qui le rend plus directement interprétable.
Formule de König-Huygens
En pratique, on préfère souvent la formule équivalente, plus rapide à calculer :
Lecture : « la variance est l'espérance du carré, moins le carré de l'espérance. »
Propriétés de la variance
- , avec égalité si et seulement si est une constante presque sûrement.
- Pour : (une constante ajoutée ne change pas la dispersion).
- Si et sont indépendantes : .
Exemple : Reprise de la tombola
On a trouvé . Calculons :
Donc :
L'écart type de 14 € est bien supérieur à l'espérance de 3 € : les gains sont très dispersés, ce qui est caractéristique des jeux de hasard à gros lots rares.
Comprendre intuitivement : la variable aléatoire comme « compteur du hasard »
Maintenant que les définitions formelles sont posées, prenons un peu de recul pour en saisir l'essence.
Imaginez que vous êtes arbitre d'un tournoi de fléchettes. À chaque lancer, vous notez le score obtenu : 1, 3, 5, 10 points selon la zone touchée. Ce que vous faites, instinctivement, c'est définir une variable aléatoire ; vous associez un nombre à chaque résultat possible. La variable aléatoire discrète est exactement ce « traducteur » qui transforme des événements qualitatifs en une grandeur numérique.
L'espérance est la valeur que l'on s'attend à obtenir sur le long terme. Ce n'est pas nécessairement une valeur que la variable peut prendre concrètement : l'espérance du dé équilibré vaut 3,5, alors qu'aucun lancer ne donnera jamais 3,5.
La variance, quant à elle, est une mesure de la « fiabilité » de cette moyenne. Une variance faible signifie que les résultats sont concentrés près de l'espérance ; une variance élevée signifie qu'ils peuvent s'en éloigner beaucoup.
Représentation graphique : diagramme en bâtons et fonction de répartition en escalier
Une variable aléatoire discrète se visualise naturellement grâce à deux graphiques complémentaires.
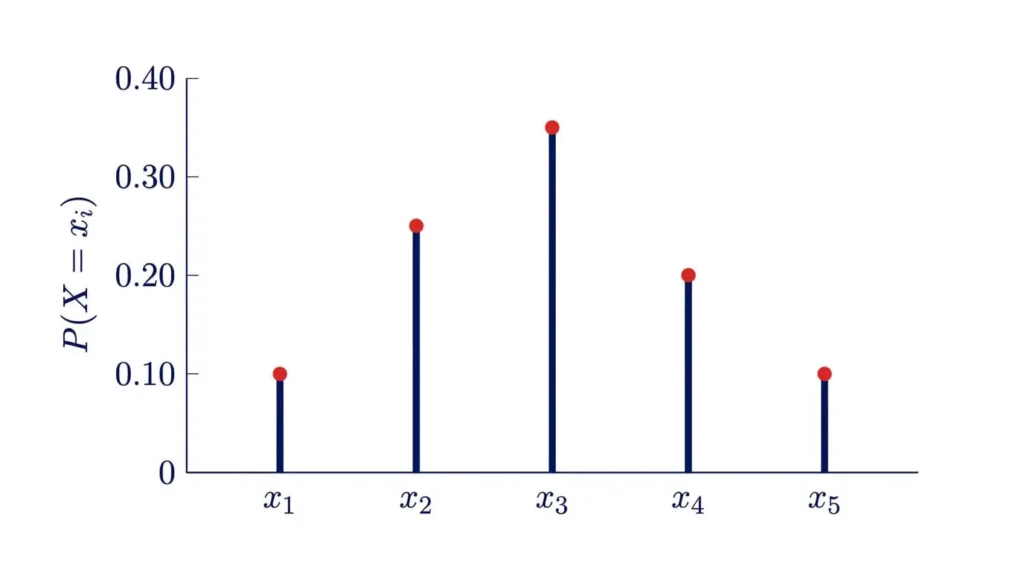
Le diagramme en bâtons représente, pour chaque valeur , un bâton vertical de hauteur . La somme des hauteurs vaut toujours 1.
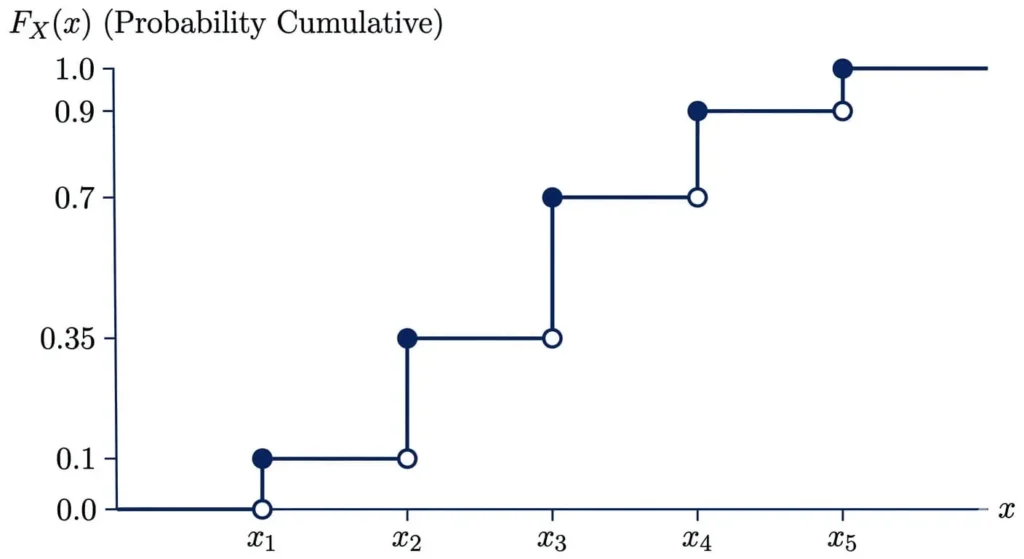
La fonction de répartition en escalier saute d'une hauteur à chaque valeur . Lire ce graphe permet immédiatement de trouver pour n'importe quel réel .
Les grandes lois discrètes : loi binomiale et loi de Poisson
Certaines variables aléatoires discrètes reviennent si fréquemment en pratique qu'on leur a donné un nom et calculé une fois pour toutes leur espérance et leur variance.
La loi binomiale
On répète fois, de façon indépendante, une épreuve de Bernoulli (succès avec probabilité , échec avec probabilité ). Si est le nombre de succès, alors avec :
On a et .
La loi de Poisson
La loi de Poisson de paramètre modélise le nombre d'occurrences d'un événement rare dans un intervalle de temps ou d'espace fixé. Si :
On a et ; espérance et variance sont égales, propriété remarquable de cette loi.
⚠️ Erreur fréquente : Pour appliquer la loi binomiale, les épreuves doivent être indépendantes et la probabilité de succès constante. Si le tirage est effectué sans remise dans une urne, c'est la loi hypergéométrique qui s'applique, pas la loi binomiale.
Pour une étude complète de la loi binomiale, rendez-vous sur notre cours dédié à la loi binomiale : cours, propriétés et exercices corrigés.
Démonstration : formule de König-Huygens pour la variance
Voyons maintenant pourquoi la formule est vraie. Cette preuve est un excellent exercice de manipulation algébrique de l'espérance.
- Partir de la définition. Posons . Par définition :
- Développer le carré.
- Appliquer la linéarité de l'espérance.On a utilisé que (constante) et .
- Substituer .
La formule est démontrée. Elle n'est qu'une conséquence directe du développement d'un carré et de la linéarité de l'espérance.
Conclusion
La variable aléatoire discrète est bien plus qu'un outil technique : c'est un langage universel pour décrire et analyser tout phénomène aléatoire dont les issues sont dénombrables. En résumé :
- Une variable aléatoire discrète est une application de vers dont l'image est un ensemble fini ou dénombrable.
- Sa loi de probabilité est entièrement décrite par les valeurs , avec .
- L'espérance donne la valeur moyenne théorique ; la variance mesure la dispersion autour de cette moyenne.
- Les lois usuelles (loi binomiale et loi de Poisson) sont des modèles prêts à l'emploi pour de nombreuses situations réelles.
Maîtriser la variable aléatoire discrète ouvre la porte à des concepts plus avancés : les chaînes de Markov, la théorie de l'information, les tests statistiques. Continuez votre parcours avec nos cours sur la loi binomiale et ses applications.
Référence externe : Pour une présentation rigoureuse et complémentaire, consultez l'article Variable aléatoire discrète sur Wikipédia.
Questions fréquentes sur la variable aléatoire discrète
Quelle est la différence entre une variable aléatoire discrète et continue ?
Une variable aléatoire discrète ne peut prendre qu'un ensemble fini ou dénombrable de valeurs (par exemple des entiers). Une variable aléatoire continue prend ses valeurs dans un intervalle réel ; comme la taille ou la durée de vie d'un composant. Elle est décrite par une densité de probabilité et non par des probabilités ponctuelles. En pratique : si l'on peut compter les valeurs possibles, la variable est discrète ; si elles remplissent un intervalle, elle est continue.
Comment calculer l’espérance d’une variable aléatoire discrète ?
On multiplie chaque valeur possible par sa probabilité , puis on additionne tous ces produits : . Si la variable suit une loi usuelle, on applique directement les formules connues : pour une loi , et pour une loi .
Qu’est-ce que la loi de probabilité d’une variable aléatoire discrète ?
La loi de probabilité de est la donnée complète de toutes les probabilités pour chaque valeur que peut prendre . Elle doit satisfaire deux conditions : chaque probabilité est entre 0 et 1, et leur somme vaut exactement 1. Connaître la loi de , c'est connaître tout ce qu'il y a à savoir sur son comportement probabiliste.
Comment démontrer qu’une variable aléatoire est discrète ?
Il suffit de montrer que l'ensemble image est fini ou dénombrable (en bijection avec une partie de ). Par exemple : si compte le nombre de succès dans une série d'épreuves, ; donc est discrète. Si peut prendre toutes les valeurs d'un intervalle , elle n'est pas discrète.