La simulation et les échantillons en Première relient une loi théorique à des données produites. Un programme simule une variable aléatoire, répète l'expérience et calcule une moyenne observée.
En augmentant la taille n, les moyennes d'échantillon se concentrent généralement autour de l'espérance. Répéter N échantillons permet d'étudier cette dispersion plutôt que de juger le modèle sur une seule réalisation.
Programmer une expérimentation reproductible
- Écrire une fonction qui renvoie une réalisation de X selon sa loi.
- Générer une liste de n réalisations et calculer sa moyenne.
- Répéter l'échantillon N fois et mémoriser les moyennes.
- Compter celles qui satisfont le critère d'écart choisi.
- Faire varier n et commenter la proportion sans transformer l'observation en certitude.
Définir une moyenne d’échantillon
La moyenne varie d’un échantillon à l’autre
Un échantillon de taille d'une variable est une liste de valeurs simulées selon la loi de . Sa moyenne est la somme des valeurs divisée par . Elle varie d'un échantillon à l'autre.
Simuler le gain moyen d’un jeu
On reprend une variable de gain d'espérance euro et on simule 1 000 échantillons de 100 parties.
- Chaque partie génère 6, 1 ou -2 selon les probabilités de la loi.
- On calcule la moyenne de 100 gains pour un échantillon.
- On répète 1 000 fois et obtient 1 000 moyennes.
- Le nuage est centré près de et reste dispersé.
- Avec , les moyennes sont en général plus resserrées.
Relier taille, espérance et dispersion des moyennes
Effet de la taille sur la dispersion
La moyenne des échantillons se centre autour de l'espérance . La dispersion typique des moyennes diminue lorsque augmente et est reliée à . Le programme propose d'observer la proportion d'écarts inférieurs à .
Expliquer pourquoi une simulation ne prouve pas la loi
Simulation, indice plutôt que preuve
Le programme utilise le hasard du générateur pour produire des données compatibles avec la loi choisie. Retrouver approximativement l'espérance contrôle le code et illustre le modèle, mais ne démontre pas les probabilités qui ont servi à générer les valeurs.
Visualiser une distribution de moyennes
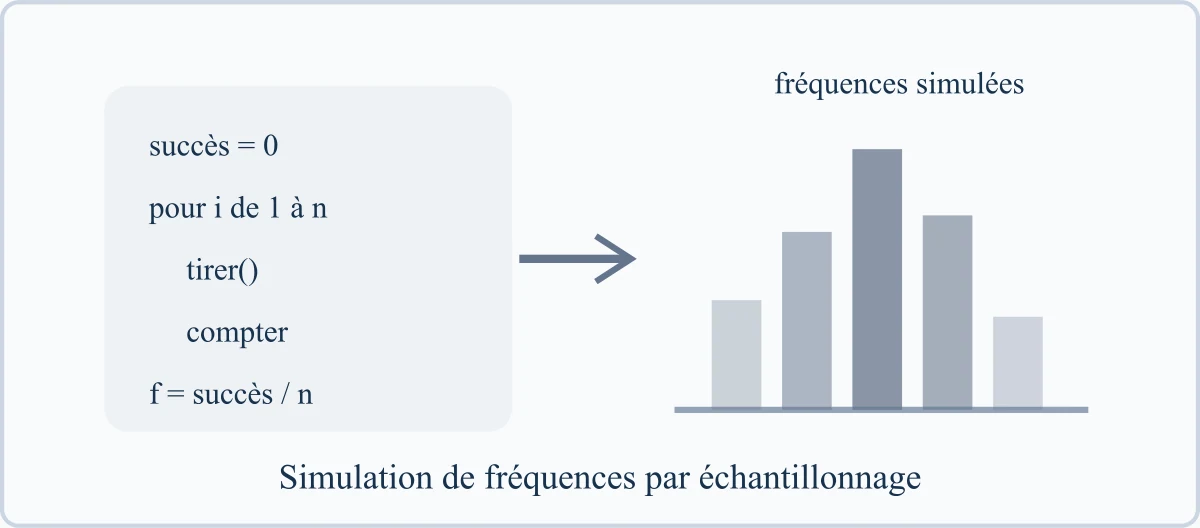
Un histogramme des moyennes montre leur centre et leur dispersion. Comparer plusieurs tailles n sur la même échelle rend visible le resserrement. Afficher seulement une moyenne finale masquerait cette variabilité.
Estimer et mesurer l’incertitude expérimentale
Les simulations de Monte-Carlo approchent une aire ou par fréquence. Les moyennes d'échantillon estiment une moyenne de population. Dans chaque cas, l'estimation doit être accompagnée de la taille et du protocole.
La simulation repose sur la loi et l'espérance d'une variable aléatoire. Une variable à plusieurs étapes peut être construite avec les arbres de probabilités.
Cette progression respecte le programme officiel de mathématiques du niveau dans le cadre de simulation et échantillons Première. Les prolongements signalés servent directement à estimer et mesurer l'incertitude expérimentale.
Fixer le protocole avant d’interpréter
Erreur fréquente : augmenter le nombre N d'échantillons décrit mieux leur distribution, tandis qu'augmenter n réduit la variabilité de chaque moyenne. Ces deux paramètres n'ont pas le même rôle.
Contrôle utile : fixer temporairement une graine pour reproduire un test, puis la changer afin de vérifier que la conclusion ne dépend pas d'un tirage particulier.